El resumen del día
Informe IA — 02/10/2026: Argón restringido, Pi Durable, Adobe interactivo y la carrera por la latencia
Si trabajas con IA, lo práctico es esto: algunos de los modelos más capaces ya no se entregan al público general porque su uso indebido podría causar daños reales, y esa decisión cambia cómo planificas despliegues, pruebas y seguridad en producción.
Lo esencial: seguridad y capacidad van de la mano
Google ha presentado Gemini 4 Argón y, por primera vez entre los grandes, ha decidido no abrirlo a desarrolladores ni a suscriptores: solo un grupo de expertos en ciberseguridad puede probarlo vía el programa Fairwind, y la razón es directa y práctica, un modelo con esta capacidad en manos equivocadas puede hacer daño real, así que la empresa prioriza control sobre adopción rápida; importa porque Argón no es solo un número alto en benchmarks —lidera DeepSWE, AutomationBench y CWE-bench— sino que ya está actuando en producción dentro de Google, reescribiendo más de 800.000 líneas del kernel Zircon a Rust con auditorías y liberando más de 300 TiB de memoria en sus centros de datos mediante optimizaciones autónomas, lo que significa que la frontera de la automatización del código y la optimización de infra está cambiando de manos y de responsabilidades, y si gestionas software crítico debes replantearte políticas de acceso, pruebas de adversarialidad y planes de contingencia antes de confiar tareas sensibles a modelos externos, ver más en WWWhat's New IA.
Pi 1.0 y Pi Durable: arneses listos para producción
La comunidad de harnesses suma dos hitos: Pi 1.0 estabiliza capacidades clave —soporte nativo para múltiples modelos, carga diferida de herramientas y mensajes de sistema dependientes del transcript— mientras que Pi Durable lleva el arnés a TypeScript, externaliza estado y añade checkpoints que permiten supervivencia ante fallos y ejecución concurrente en entornos JS, de manera que lo que antes era investigación experimental se acerca a ser una pieza reutilizable en stacks de producción, lo que cambia la hoja de ruta de cualquier equipo que construya agentes persistentes y flujos multi-step con rollback, y puedes leer el detalle técnico en Latent Space.
Editor Adobe dentro de ChatGPT: edición guiada en contexto
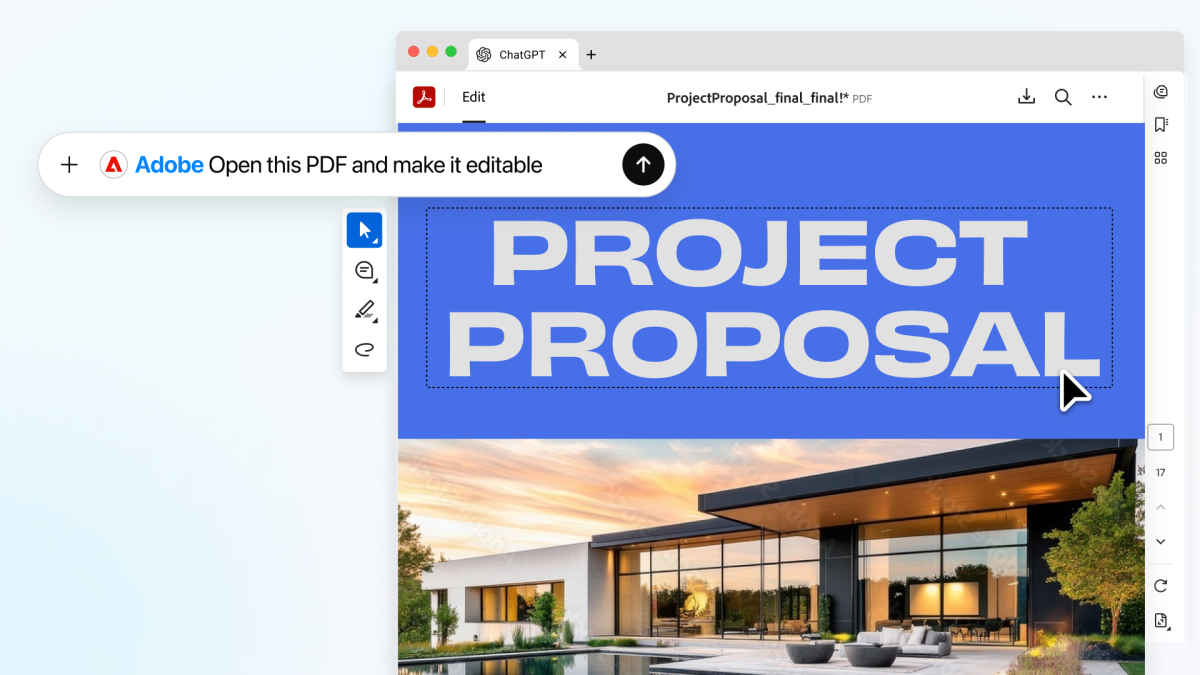
Adobe y OpenAI han dado un salto de UX al integrar Photoshop y Acrobat en un panel lateral de ChatGPT que expone sliders dinámicos y editores contextuales sincronizados bidireccionalmente con la conversación, lo que evita repetir instrucciones y convierte la edición visual en un diálogo continuado donde las acciones en el editor alimentan el contexto y las peticiones del chat ajustan los controles, una novedad conceptual que reduce fricción para diseñadores y workflows creativos y altera cómo conectar experiencia humana y modelos en procesos iterativos, descripción y demo en WWWhat's New IA.
Latencia como ventaja competitiva: GPT-6 Astra Ultrafast
OpenAI ofrece ahora GPT-6 Astra Ultrafast sobre GPUs Blackwell de NVIDIA, con hasta 8x más velocidad en generación de tokens para casos donde la latencia se multiplica por iteración —agentes que escriben, prueban y vuelven a escribir se benefician directamente— y la colaboración técnica con NVIDIA no es trivial porque implica optimizaciones de inferencia que reducen tiempos, costes y mejoran la experiencia interactiva para aplicaciones sensibles al retardo; detalles técnicos en el blog de NVIDIA NVIDIA.
Hardware y herramientas: tablets con Photoshop y expectativas de ejecución local
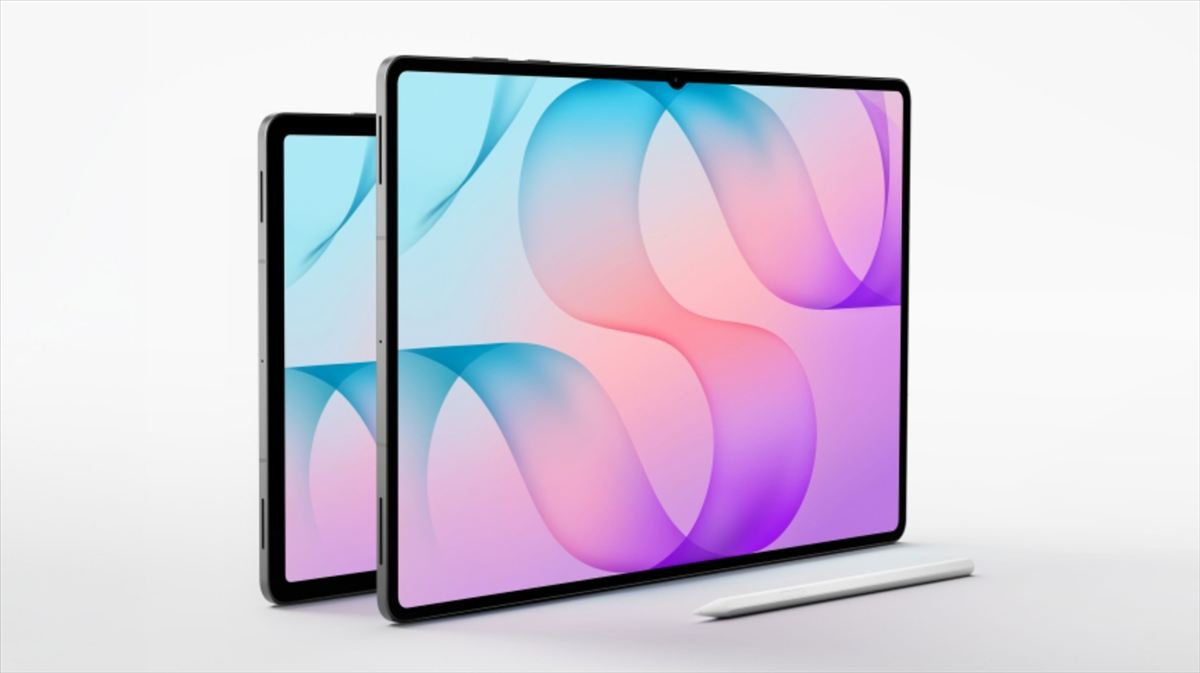
Samsung lanza las Galaxy Tab S12+ y S12 Ultra con Photoshop completo en la caja y S Pen incluido, además de NPUs más potentes y siete años de actualizaciones, lo que sitúa a las tablets Android como plataformas viables para cargas creativas y modelos locales, un recordatorio de que la frontera no es solo cloud sino también dispositivos endpoints capaces de ejecutar inferencia útil en contextos de usuario final, más en WWWhat's New IA.
Investigación y talento: Alex Zhang y la ambición académica
La entrevista con Alex Zhang (MIT) devuelve foco a la academia como semillero de ideas de alto impacto técnico —Recursive Language Models, kernels escritos por IA, subagentes persistentes— y subraya que algunas apuestas arriesgadas quedan fuera del calendario de las grandes empresas, por lo que seguir la producción académica es estratégico para detectar próximos saltos arquitectónicos; lectura en Latent Space.
Si algo queda claro hoy es que la carrera ya no es solo quién tiene el mejor modelo, sino quién lo despliega con control: ¿estás preparado para gobernar lo que ya es capaz de romper y mejorar a la vez?
Analizado hoy...
Estas son las noticias analizadas hoy, a las que puedes acceder para conocer más detalle.
Gemini 4 Argón: Google lanza su modelo más capaz de la historia y solo pueden probarlo expertos en ciberseguridad
[AINews] Pi 1.0, Pi Durable y AIE NYC
Adobe lleva Photoshop y Acrobat al panel lateral de ChatGPT: ya puedes editar imágenes con sliders mientras conversas
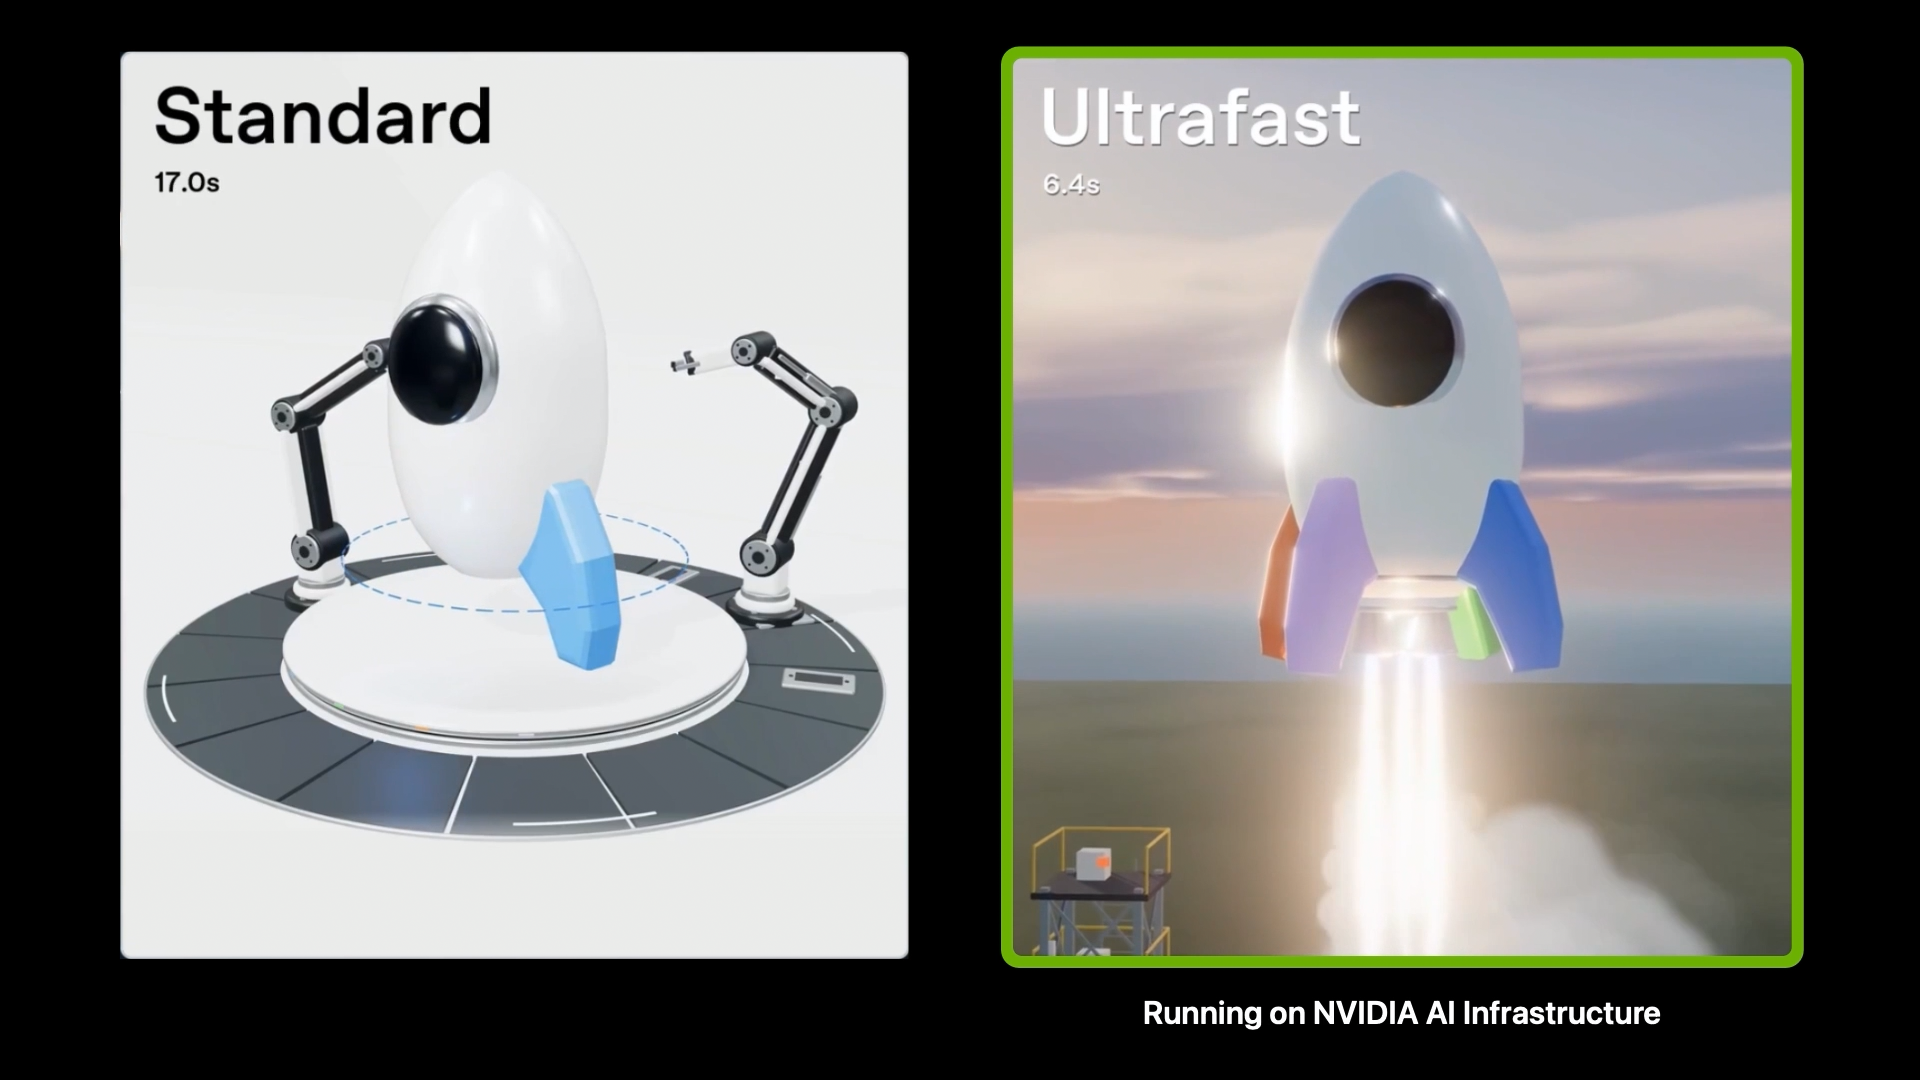
Cómo las GPU de NVIDIA ayudan a acelerar GPT-6 Astra Ultrafast de OpenAI