El resumen del día
Todas estas notas se leen como variaciones de la misma pregunta: ¿cómo y cuándo externalizamos decisiones—de razonamiento, detección de autoría, diseño de interfaz o voz—al sistema y qué coste humano o técnico cargamos con ello?
Patrón común
Al poner estas piezas juntas se dibuja una tensión constante entre eficiencia y control: los modelos prometen automatizar pasos complejos, pero cada opción de automatización trae consigo costes ocultos, sesgos y una capa de ingeniería que no desaparece: cambia de sitio. Algunas soluciones actúan dentro del modelo, otras en la fábrica que lo adapta y otras en la interfaz que decide qué se te muestra y cuándo; todas plantean la misma pregunta práctica: ¿me compensa externalizar esto o me conviene retener la decisión?
Modelos que «piensan»: ¿pagar por el borrador invisible?
La guía sobre modelos de razonamiento deja claro que activar el modo que «razona» no es una mejora gratuita: el modelo genera tokens internos —un borrador de pensamiento— que no ves pero sí pagas, y ese coste tiene sentido cuando la tarea exige pasos múltiples, comprobaciones intermedias o integración de documentos largos; sin embargo, para consultas puntuales, clasificación o redacción sencilla, ese gasto es prescindible, y la latencia adicional puede ser contraproducente. Importa porque confundir coste con beneficio lleva a facturas mayores y a esperas innecesarias, y porque las tres grandes (OpenAI, Anthropic y Google) coinciden en el mismo diagnóstico: el razonamiento dinámico mejora tareas complejas, pero la decisión de activarlo debe ser una política operativa, no un interruptor por defecto. Más información en este artículo: Modelos de IA «de razonamiento».
Detectores de texto: riesgos reales para quienes escriben en otra lengua
Los detectores de IA que analizan estilo fallan y perjudican a hablantes no nativos porque miden previsibilidad, no autoría, y textos con vocabulario limitado o estructuras sencillas se etiquetan erróneamente como generados por máquina; un estudio con ensayos del TOEFL mostró un porcentaje preocupante de falsos positivos. La consecuencia práctica es evidente: políticas académicas o editoriales que dependen de esos detectores pueden sancionar a la persona equivocada, y la alternativa técnica —marcas de agua— solo funciona si el generador las implementa, lo que no es el caso general. El análisis completo está disponible aquí: ¿Se puede saber si un texto está escrito con IA?.
Cómo promptar bien: claridad y formato por encima de trucos
OpenAI, Anthropic y Google publican guías de prompting que coinciden —contexto, ejemplos, formato y división de tareas—, y la lección práctica es que no hay atajos mágicos: la mejora viene de especificar límites y estructura, no de fórmulas virales. Para usuarios y desarrolladores, aplicar estas normas reduce iteraciones y coste computacional, porque un buen prompt evita que el modelo «piense» de más o produzca salidas irrelevantes; puedes leer las técnicas comparadas aquí: Cómo escribir buenos prompts.
Fábricas de modelos y la interfaz de atención
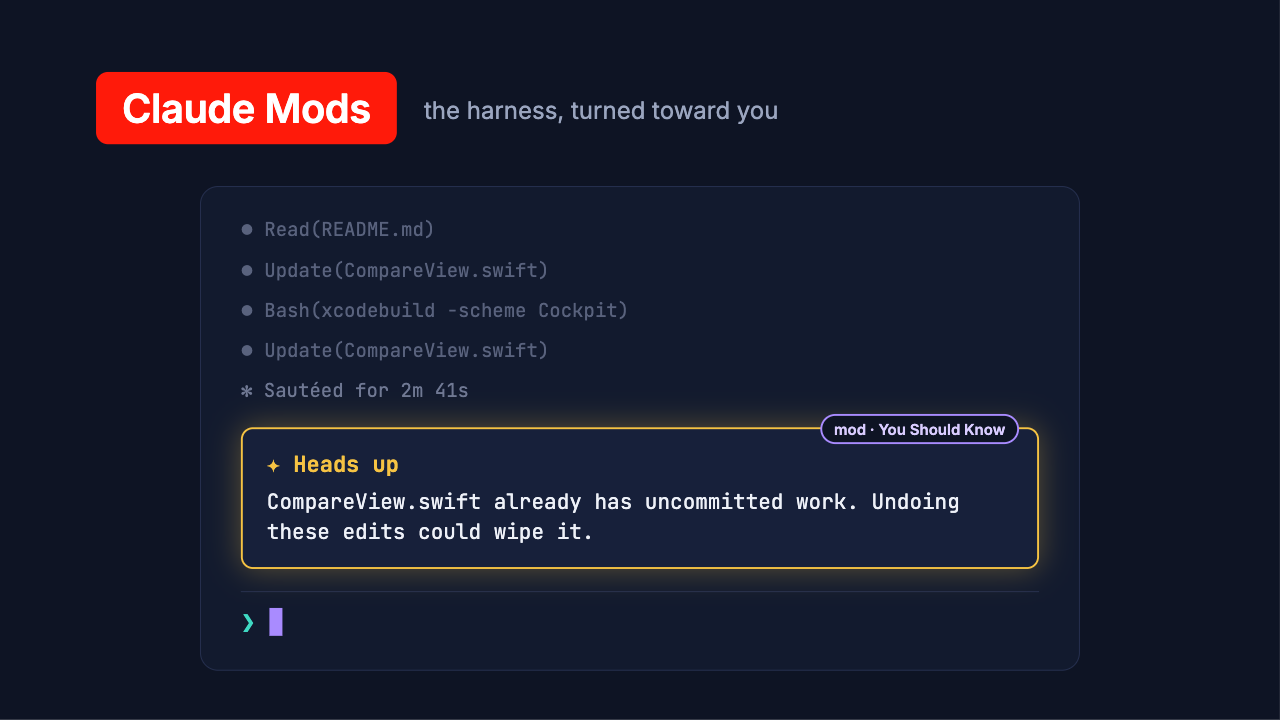
La idea de que la fábrica de modelos —el post‑entrenamiento profundo y la personalización— importa más que el peso original del modelo se confirma en experiencias de Thomson Reuters y otras empresas: para tareas propietarias no basta RAG o LoRA, hace falta re‑preentrenamiento y una cadena de post‑entrenamientos que preserve capacidades generales mientras introduce conocimiento concreto. Paralelamente, iniciativas como Claude Mods muestran que el arnés del agente vira hacia la interfaz de atención, es decir, hacia cómo el sistema decide cuándo pedir tu intervención y qué mostrarte, y eso redefine quién controla la acción final.
Voz y agentes de voz: Voxtral 3
Mistral lanza Voxtral 3, una familia que combina transcripción, TTS y un SDK de agente de voz que promete unir escucha, razonamiento y llamadas a herramientas en un solo flujo; es una apuesta por integrar voz en pipelines complejos y por ofrecer modelos orientados a diarización y multitarea, con opciones para entornos con recursos limitados. Toda la nota técnica está aquí: Mistral Voxtral 3.
Si vas a delegar, decide primero qué delegas: el modelo puede pensar, hablar y personalizarse, pero la factura, el sesgo y la interfaz de atención las asumes tú.
Analizado hoy...
Estas son las noticias analizadas hoy, a las que puedes acceder para conocer más detalle.
Modelos de IA «de razonamiento»: qué son, cuánto cuestan y cuándo merece la pena dejarlos pensar
¿Se puede saber si un texto está escrito con IA? Por qué los detectores fallan y a quién perjudican
Cómo escribir buenos prompts: las técnicas en las que coinciden OpenAI, Anthropic y Google